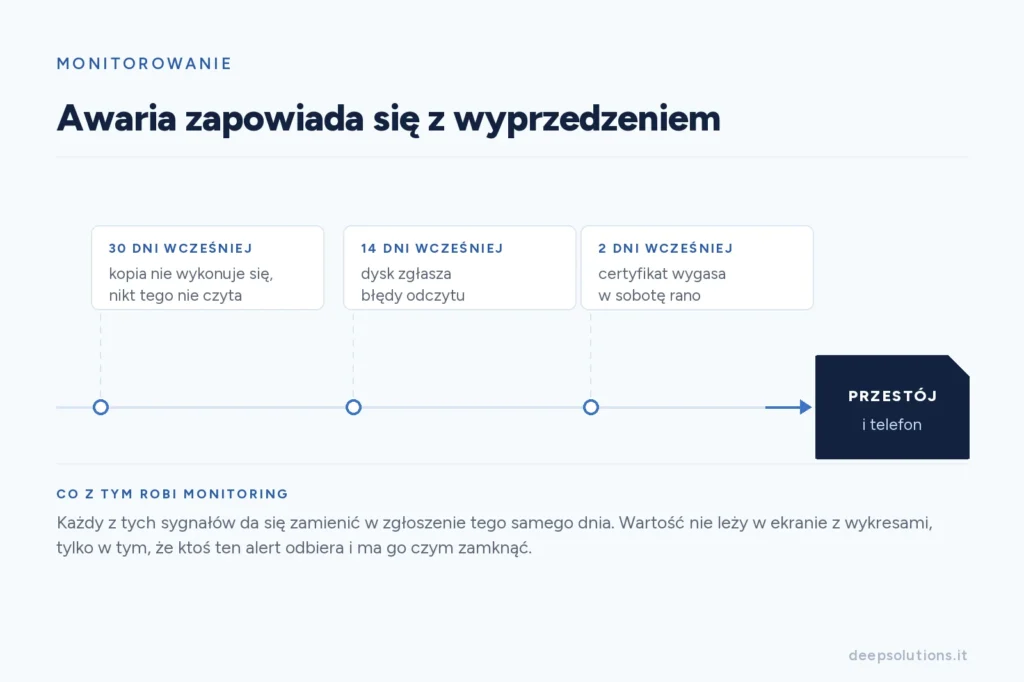
Większość incydentów IT, które obsługujemy u klientów, dało się przewidzieć: dysk sygnalizował błędy SMART na tygodnie przed śmiercią, backup nie wykonywał się od miesiąca, certyfikat wygasł w sobotę. Różnica między firmą, która o tym wie z wyprzedzeniem, a firmą, która dowiaduje się od pracowników, to właśnie monitoring infrastruktury IT.
Co realnie monitorujemy
Monitoring to ciągłe zbieranie i analiza stanu systemów: dostępność usług, zajętość dysków, kondycja macierzy i backupów, wygasające certyfikaty i domeny, logi bezpieczeństwa. W ramach opieki IT w Deep Solutions każdy serwer i urządzenie sieciowe klienta trafia pod monitoring pierwszego dnia współpracy — bo bez tego świadczenie opieki to zgadywanie.
Co monitoring wykrywa po stronie bezpieczeństwa
- Złośliwe oprogramowanie (malware) – nietypowe procesy, masowe zmiany plików (typowy sygnał startującego ransomware), połączenia do znanych złych adresów.
- Phishing i przejęcia kont – logowania z nietypowych lokalizacji i o nietypowych porach, np. do Microsoft 365.
- Ataki na usługi wystawione do internetu – serie nieudanych logowań na VPN, RDP czy pocztę.
- Wyciek danych – anomalie w ruchu wychodzącym, których nikt nie zauważy bez zbierania metryk sieciowych.
Narzędzia, których używamy i które polecamy
- Zabbix – open-source, monitoruje serwery, przełączniki, UPS-y i aplikacje; dobrze skaluje się od kilku do setek hostów i jest naszym standardem w infrastrukturze klientów.
- Prometheus + Grafana – metryki i dashboardy, naturalny wybór w środowiskach kontenerowych i przy własnych aplikacjach.
- Wazuh / rozwiązania SIEM – zbieranie i korelacja logów bezpieczeństwa; komercyjnie Splunk lub Microsoft Sentinel, jeśli firma ma budżet i wymogi compliance (np. NIS2).
Na czym monitoring najczęściej się wykłada
1. Fałszywe i nadmiarowe alarmy
System, który wysyła 200 alertów dziennie, uczy ludzi ignorowania alertów — i wtedy ten jeden istotny przepada. Progi i zależności między alertami trzeba stroić: alarmujemy o skutku (usługa nie działa), a nie dziesięcioma powiadomieniami o każdej przyczynie z osobna.
2. Martwe pola
Monitoring obejmujący „główne serwery” pomija zwykle to, co faktycznie się psuje: UPS-y, NAS-y, drukarki sieciowe, stacje z krytycznym oprogramowaniem. Inwentaryzacja przed wdrożeniem monitoringu to połowa jego wartości.
3. Brak reakcji na alerty
Najdroższy monitoring bez ustalonego procesu „kto reaguje i w jakim czasie” jest tylko archiwum nieszczęść. Narzędzia open-source sprowadzają koszt licencji do zera — realnym kosztem jest utrzymanie i reagowanie, i to trzeba zaplanować.
Dokąd to zmierza
Trzy kierunki, które realnie widać w praktyce: detekcja anomalii wspierana uczeniem maszynowym (mniej ręcznego strojenia progów), automatyczna reakcja na incydenty (SOAR — np. automatyczna izolacja zainfekowanej stacji) oraz model Zero Trust, w którym monitoring tożsamości i dostępów staje się równie ważny jak monitoring serwerów. Dla firm objętych NIS2 monitorowanie i raportowanie incydentów przestaje być opcją, a staje się obowiązkiem.
Podsumowanie
Monitoring to najtańszy sposób na zamianę awarii w planowaną interwencję serwisową. Jeśli dziś nikt w Twojej firmie nie dostaje alertu, gdy kończy się miejsce na dysku serwera albo nie wykona się backup — skontaktuj się z nami, wdrożymy monitoring i będziemy na niego reagować.

